Quanto costa far girare in casa un modello di intelligenza artificiale come GLM per 2.000 ingegneri, e converrebbe anche a noi?
Per rispondere sono partito da ciò che ha detto David Abitbol, di Revolut, all’AI Engineer di New York (una conferenza sull’intelligenza artificiale) il 13 ottobre 2026. Ho rifatto i conti con i prezzi di listino del 5 novembre 2026, in sei tappe: dal fatto ai conti di Revolut, fino a che cosa servirebbe a un team piccolo.
«Noi» è qui un’azienda con un team piccolo di sviluppatori. «In casa» vuol dire non con le API (il servizio a pagamento con cui si usa un modello dai server del produttore), ma su schede di calcolo scelte dall’azienda: nei conti, a noleggio. Anthropic e OpenAI sono le aziende dietro Claude e ChatGPT; GLM è un modello di intelligenza artificiale dell’azienda cinese Z.ai, che Revolut usa per far scrivere programmi ai suoi ingegneri.
Le citazioni di Abitbol sono tradotte da me; gli originali inglesi sono nella nota di metodo.
Che cosa ha detto Abitbol?
Revolut è una banca digitale europea. Abitbol, che nel talk dice di guidare le operazioni AI dell’azienda, racconta che intorno ad aprile 2026 Revolut ha cominciato a far girare in proprio (in inglese «self-hosting»), con GPU dedicate, un modello «aperto», cioè con i pesi scaricabili: i pesi sono i numeri che ne formano la «conoscenza» dopo l’addestramento. È GLM, oggi nella versione 5.3, usato per scrivere codice.
Le cifre che dà, dal palco:
- «per servire 2.000 ingegneri ci servono più o meno 56 B200»: 56 schede di calcolo (GPU, di Nvidia, usate per far girare l’AI) di tipo B200;
- un costo medio di 30 centesimi per milione di token (la pagina della conferenza scrive 0,30 dollari); un token è un pezzetto di testo, una parola o parte di una parola, che il modello legge o scrive;
- «la nostra fattura è un decimo di quanto spendevamo con Anthropic e OpenAI»;
- le richieste al secondo passate da circa 3 in aprile a più di 7 ad agosto, con lo stesso numero di GPU secondo la pagina della conferenza (nella trascrizione la frase non è chiara).
Sono dati dichiarati dall’azienda, non verificati da altri. Abitbol dice anche che Claude Code e Codex, gli assistenti AI di Anthropic e OpenAI che scrivono programmi con gli ingegneri, restano in uso «come eccezione» (per Claude Code è una lettura probabile: la trascrizione automatica ha «code code»).
Quanto costano 56 schede, e quanti token servono?
In breve: da 141.000 a 403.000 dollari al mese per 56 schede, a seconda del contratto; i conti sono coerenti con quello che dice Abitbol, ma non lo dimostrano.
Il primo conto: quanto costano 56 B200 a noleggio. A ore, cioè senza impegno, i prezzi pubblicati il 5 novembre 2026 dalle aziende che noleggiano schede di calcolo vanno da 7,99 dollari all’ora per scheda (RunPod) a 8,60 (CoreWeave): con 730 ore al mese, da 327.000 a 352.000 dollari per 56 schede.
Non sono un tetto: sono sotto i cluster di Lambda (gruppi di schede in affitto: da 9,36 a 9,86 dollari all’ora, da circa 383.000 a 403.000 dollari al mese) e sopra il prezzo con lo sconto fino al 60% che CoreWeave scrive di offrire per un uso impegnato, con un contratto di durata (circa 141.000 dollari al mese). I prezzi che Revolut paga non sono noti.
Il secondo conto: quanti token servono. I token si ricavano dal costo ipotizzato, quindi non confermano né smentiscono Abitbol. Prima ipotesi: i 30 centesimi sono il costo diviso per tutti i token serviti, cache compresa (cioè il testo già letto, che il servizio ricorda e rilegge a prezzo ridotto). Abitbol dice «blended cost of token», costo medio del token, e non spiega come lo conta. Seconda ipotesi: la fattura di oggi è il solo noleggio delle 56 GPU. Con i prezzi a ore le schede devono servire circa 1.100 miliardi di token al mese: con 7 richieste al secondo, giorno e notte, circa 60.000 token per richiesta.
Quanto spendevano prima, e perché non è solo questione di prezzi?
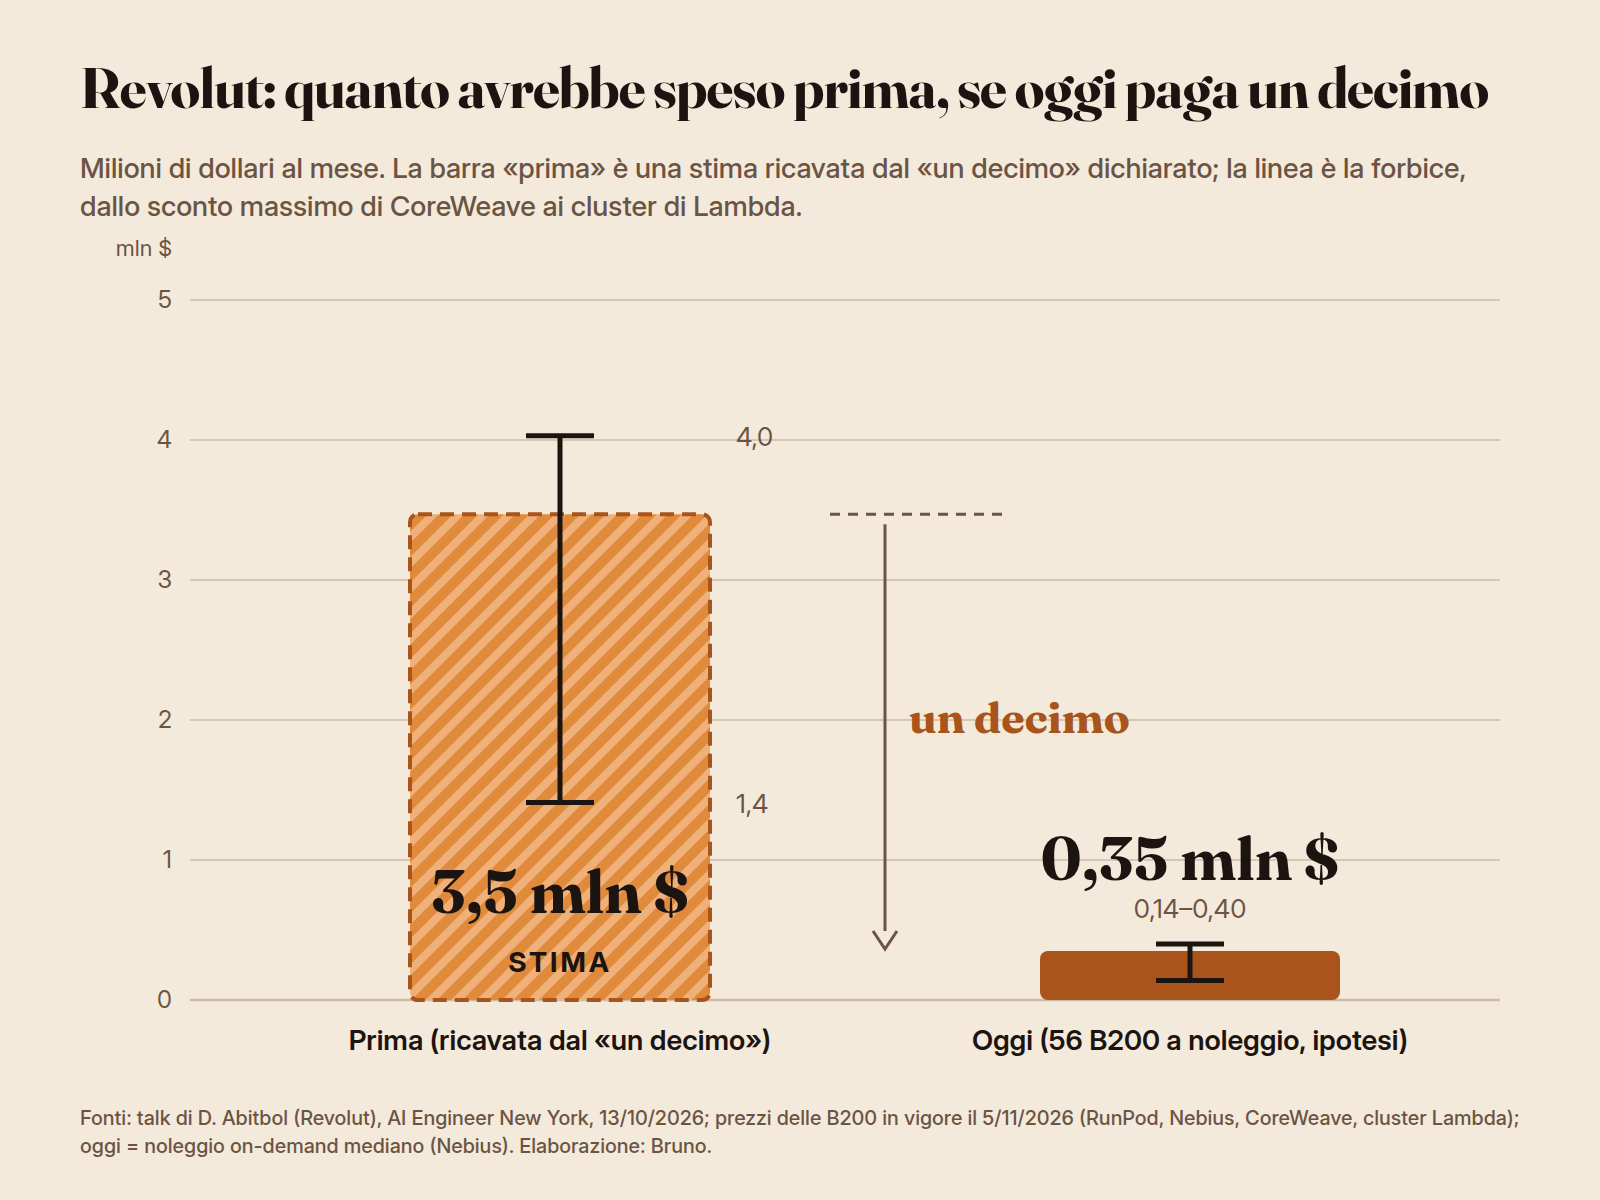
In breve: se oggi la fattura è un decimo, prima Revolut spendeva circa 3,5 milioni di dollari al mese (stima); con la cache al 90% e i prezzi di oggi delle API, il «un decimo» non si spiega con i soli prezzi.
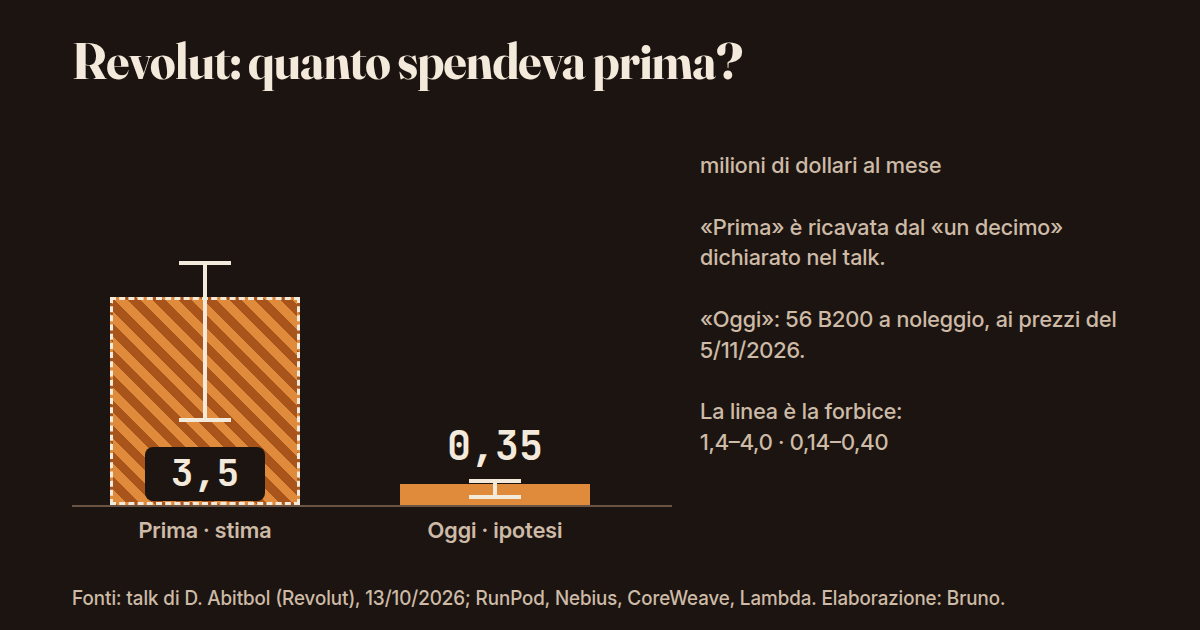
Se la fattura di oggi è un decimo (ipotesi: il solo noleggio delle 56 GPU), prima Revolut spendeva circa 3,5 milioni di dollari al mese per l’AI che scrive codice, circa 1.700 dollari per ingegnere. È una stima, non un dato: la forbice va da 1,4 a 4,0 milioni secondo il prezzo delle GPU (da 1,2 a 5,0 se «un decimo» è arrotondato, tra l’8% e il 12%). Abitbol dice che alcuni ingegneri spendevano «mille al mese, diecimila al mese» (valuta non indicata).
Il confronto con le API si fa a parità di token e ai listini di oggi, con il 2-10% di token in uscita (la parte scritta dal modello) e la cache. Il 90% di cache è la soglia che Abitbol indica ai suoi ascoltatori per un server proprio (secondo la trascrizione automatica, poco chiara), non la quota di Revolut; per questo i due scenari.
Quante volte i 0,30 dollari costerebbero le API, agli stessi token e ai listini del 5 novembre 2026:
| Modello | Cache al 50%: volte i 0,30 dollari | Cache al 90%: volte i 0,30 dollari |
|---|---|---|
| GLM-5.3 servito da Z.ai | da 3,0 a 4,0 | da 1,5 a 2,6 |
| Claude Sonnet 5.5 | da 4,1 a 6,5 | da 1,6 a 4,2 |
| gpt-5.3-codex | da 4,1 a 7,6 | da 2,0 a 5,7 |
| Claude Opus 5.5 | da 8,2 a 13 | da 3,2 a 8,4 |
Agli stessi token e ai listini di oggi, con la cache al 90% le API costerebbero da 1,5 a 8 volte i 0,30 dollari; con la cache al 50%, da 3 a 13 volte (per Opus 5.5 da 8,2 a 13, quindi il 10 rientra).
Il confronto fissa i token: Abitbol dice che Claude Code era partito «con limiti di budget rigidi» e che le richieste sono aumentate. Se oggi Revolut usa più token di prima, il rapporto tra i prezzi di allora e di oggi dovrebbe superare 10, non restare sotto. Il «un decimo» è quindi compatibile con più spiegazioni: modelli più costosi o prezzi più alti di allora (i listini di gennaio-aprile 2026 non sono tra le fonti lette), meno cache, volumi diversi, o una fattura che comprende altro. Il talk non dice quale.
E se volessimo farlo anche noi? Che cosa serve
In breve: servono schede di calcolo molto potenti in un solo server; un computer normale non basta.
La guida tecnica di vLLM, il programma che fa girare il modello, indica per i pesi ufficiali, compressi in formato FP8 (un formato che stringe i numeri del modello per farli stare in meno memoria), un server con 8 GPU H200 (1.128 GB di memoria in tutto). Per il contesto da un milione di token (la lunghezza massima del testo che il modello può leggere) indica invece 8 B200. H200, H100 e B200 sono modelli di schede di calcolo di Nvidia.
GLM-5.3 ha circa 750 miliardi di parametri, i numeri interni del modello: più sono, più il modello è grande e occupa memoria (743 secondo la guida di vLLM, 753 contati da Hugging Face, il sito dove si scaricano i modelli, sui file del modello). I pesi in FP8 pesano circa 755 GB: non stanno in un computer normale, ma in un server con 8 schede di calcolo molto potenti.
- L’hardware. Con 8 H100 (640 GB) non entrano. Con un formato ancora più compresso (NVFP4, preparato da terzi) i pesi scendono a circa 465 GB; quante schede bastino, la guida non lo dice.
- La licenza è permissiva: i dettagli, con le condizioni, sono nelle domande frequenti.
- Una variante più piccola, GLM-5.3-Flash (321 miliardi di parametri, licenza MIT, che permette di usare il modello quasi senza limiti), pesa comunque circa 306 GiB: non è un modello da un computer da scrivania.
Sono dati dichiarati dai progetti: nessuno è stato provato su una GPU.
Da quanti sviluppatori conviene?
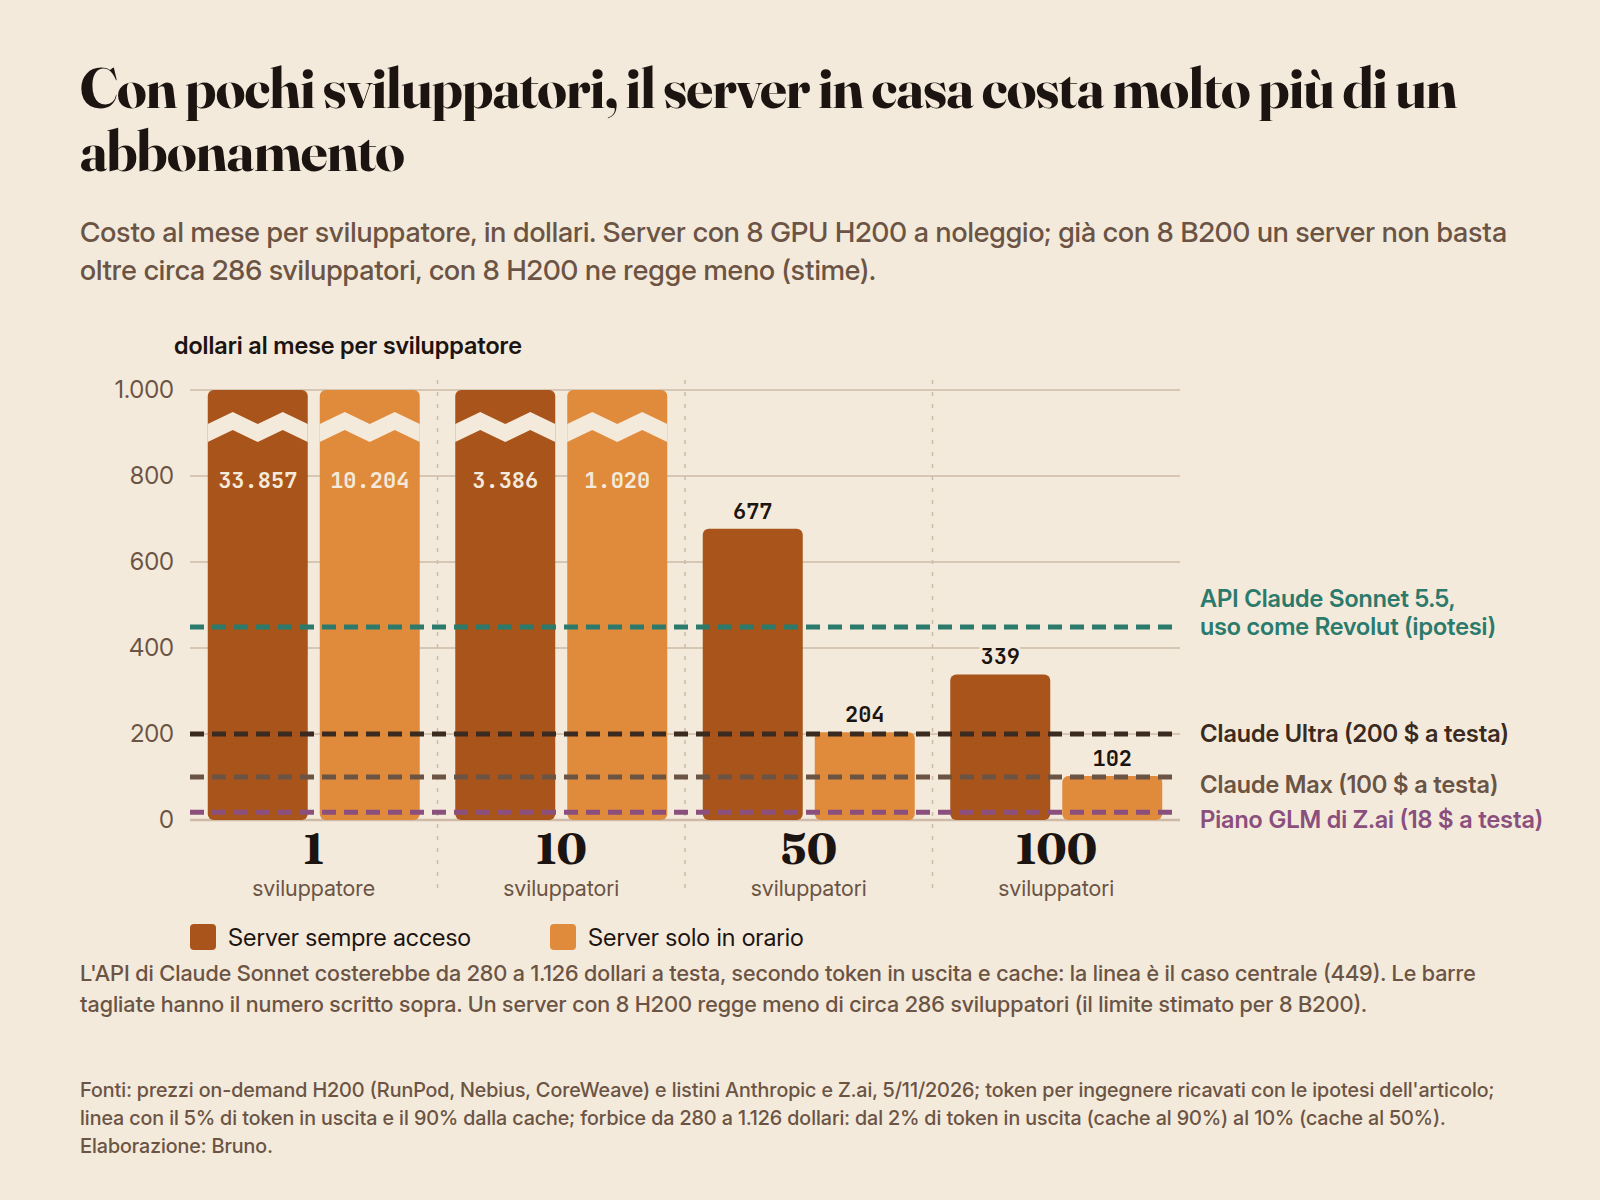
In breve: con 1 o 10 sviluppatori non conviene mai; con 50 conviene contro le API usate come Revolut (contro Opus anche con il server sempre acceso, contro Sonnet solo con il server acceso in orario); contro Claude Ultra si è al limite (47-56 sviluppatori, in orario). Per chi vuole solo usare GLM, il piano di Z.ai costa meno del server a qualunque taglia di team, ma i dati vanno a Z.ai.
Un server con 8 H200 a noleggio costa da 30.900 a 36.800 dollari al mese sempre acceso, da 9.300 a 11.100 se acceso solo in orario di lavoro (10 ore per 22 giorni). Con 10 sviluppatori sono da 930 a 1.110 dollari a testa in orario (da 3.090 a 3.680 sempre acceso); con 50, da 186 a 222 (da 618 a 736).
Le alternative, per sviluppatore e al mese:
- il piano di Z.ai per programmare con GLM, da 18 dollari (lo stesso modello, senza GPU; i dati vanno a Z.ai);
- Claude Pro 17 (con pagamento annuale; 20 al mese se mensile), Claude Max 100, Claude Ultra 200 dollari (abbonamenti mensili di Anthropic per usare Claude).
Con le API, per chi consuma come un ingegnere di Revolut (circa 580 milioni di token al mese, ricavati con le ipotesi dei conti): GLM-5.3 di Z.ai 333 dollari, Sonnet 5.5 449, gpt-5.3-codex 588, Opus 5.5 898.
Da quanti sviluppatori il server con 8 H200 costa meno dell’alternativa:
| Contro | Solo in orario | Sempre acceso |
|---|---|---|
| Piano GLM di Z.ai (18 dollari) | 518-617 (oltre la capacità di un server) | 1.717-2.046 (oltre la capacità) |
| Claude Max (100 dollari) | 94-111 | 309-369 (oltre la capacità di un server) |
| Claude Ultra (200 dollari) | 47-56 | 155-185 |
| API Sonnet 5.5, uso come Revolut (ipotesi) | 21-25 | 69-82 |
| API Opus 5.5, uso come Revolut (ipotesi) | 11-13 | 35-41 |
Questi pareggi (il numero di sviluppatori da cui il server costa meno) valgono finché un server basta. Con il rapporto di Revolut (2.000 ingegneri su 56 B200, circa 36 a scheda) un server da 8 B200 ne regge circa 286; con 8 H200 ne regge meno, ma non è misurato.
Il pareggio contro Claude Max con il server sempre acceso (309-369) sta sopra questa capacità: servirebbero due server, e il numero non vale. Il rapporto di Revolut viene da un sistema regolato con cura (tempo al primo token, cioè quello che passa prima che compaia la prima parola della risposta, da 14,26 a 1,68 secondi, secondo la pagina): un team piccolo potrebbe servire meno sviluppatori per scheda.
Che cosa i conti non contano, e che cosa le fonti non dicono?
- Che cosa il conto non include. Personale, rete, spazio, monitoraggio, sicurezza e il lavoro di messa a punto: secondo la pagina, che descrive un grafico mostrato da Abitbol, il tempo al primo token (quello che passa prima che compaia la prima parola della risposta) è sceso da 14,26 a 1,68 secondi con lo stesso numero di GPU; a voce Abitbol dice «più di 10 secondi» e «circa 1,6» (traduzione mia). La pagina della conferenza scrive che auto-ospitare lascia a Revolut la responsabilità dei costi inferiori, delle regole di sicurezza (sandbox) e della telemetria (i dati di funzionamento che servono a capire che cosa è successo se c’è un incidente).
- Accensione, guasti, aggiornamenti e abbonamenti. Spegnere il server la sera vuol dire ricaricare 755 GB di pesi al mattino; guasti e aggiornamenti non sono nel conto; gli abbonamenti sono un costo fisso a testa, senza confrontare quanto permettano di usare.
- I dati. Abitbol dice, in generale, che usare i pesi su un servizio con sede negli Stati Uniti non vuol dire usare un servizio che va in Cina: è una sua dichiarazione, a condizioni che pone lui, per compiti di programmazione.
- Che cosa contenga la fattura di Revolut, con quale periodo sia confrontata, chi possieda le GPU, i token serviti. A voce Abitbol dà circa 3 richieste al secondo in aprile e più di 7 ad agosto, e dice anche «76% increased demand» (5:43:35); la pagina riporta +76%. Da circa 3 a più di 7 sarebbe più del doppio: le cifre non coincidono e il talk non spiega perché. Nelle fonti lette nessun altro documento conferma le cifre; i listini sono del 5 novembre 2026 e cambiano spesso.
Alla domanda dell’apertura le fonti rispondono così: i conti sono coerenti con Abitbol (i token sono ricavati dal costo ipotizzato), e con la cache al 90% il «un decimo» non si spiega con i soli prezzi di oggi. Con 1 o 10 sviluppatori un server in casa costa più delle alternative; da 50 può convenire contro le API usate molto; per chi vuole solo GLM, il piano di Z.ai costa meno a qualunque taglia.
Sono conti con ipotesi dichiarate, non consigli d’acquisto.
Non resta che vedere se Revolut, o altri, pubblicheranno il costo complessivo e non solo quello dei token.
Domande frequenti
Quanto costa far girare GLM-5.3 come Revolut?
A noleggio, ai prezzi pubblicati il 5 novembre 2026, da 141.000 dollari al mese (sconto massimo di CoreWeave per un uso impegnato) a 403.000 (cluster di Lambda); a ore, da 327.000 a 352.000. Il prezzo di Revolut non è noto. Il calcolo parte da ciò che dice Abitbol: circa 56 GPU B200 per circa 2.000 ingegneri.
Da quanti sviluppatori conviene farlo in casa?
Con un server da 8 H200, da circa 11 a 13 sviluppatori contro le API di Opus 5.5 usate come Revolut, e da circa 94 a 111 contro un abbonamento Claude Max, se il server è acceso solo in orario e ne regge tanti (non misurato). Sempre acceso, servono da 35 a 185 sviluppatori, secondo l’alternativa; contro Claude Max (309-369) un solo server non basta. Con 1 o 10 sviluppatori non conviene mai.
Si può usare GLM-5.3 per lavoro?
Secondo la licenza letta su Hugging Face, sì: uso, modifica e messa a punto sono permessi, con l’avviso di copyright da mantenere e il rispetto delle leggi. Solo chi offre a terzi un servizio di AI con ricavi complessivi sopra i 10 miliardi di dollari in 12 mesi deve passare una verifica di sicurezza di Z.ai. Non è un parere legale.
Il «un decimo» di Revolut è vero?
Non si può verificare: è un dato dichiarato dal palco. I conti lo rendono coerente, ma con la cache al 90% i soli prezzi di oggi non lo spiegano: agli stessi token le API costerebbero da 1,5 a 8 volte i 0,30 dollari per milione, non 10 (con la cache al 50%, fino a 13).
Quante GPU servono per far girare GLM-5.3?
Con i pesi ufficiali in formato FP8, che pesano circa 755 GB, la guida tecnica di vLLM indica un server con 8 GPU H200 (schede di calcolo di Nvidia; 1.128 GB di memoria in tutto), oppure 8 B200 per il contesto da un milione di token. Con 8 H100 (640 GB) non entrano. Con un formato ancora più compresso (NVFP4, preparato da terzi) i pesi scendono a circa 465 GB; quante schede bastino, la guida non lo dice.
Quanto spendeva Revolut prima?
È una stima, non un dato: se la fattura di oggi è un decimo (ipotesi: il solo noleggio delle 56 GPU), prima Revolut spendeva circa 3,5 milioni di dollari al mese per l’AI che scrive codice, circa 1.700 dollari per ingegnere, con una forbice da 1,4 a 4,0 milioni secondo il prezzo delle GPU. Abitbol non dice a quale periodo si riferisca il «un decimo».
Leggi anche
- Togliere i freni a un modello come GLM-5.3 costa circa 1.200 dollari, stima Anthropic: chi ne approfitta?: lo stesso modello, GLM-5.3, in un altro contesto, le versioni con i rifiuti tolti (non riguarda Revolut).
- Un Raspberry Pi 5 con un chip “neuromorfico” a 1.295 dollari: che cosa promette BrainChip e che cosa non si sa ancora: hardware per far girare l’AI in locale, con il prezzo riportato da una testata (il comunicato del produttore non lo indica).
Nota di metodo (per chi vuole controllare i conti)
Un controllo dei token: con il 5% di token in uscita, ogni scheda dovrebbe generare da 370 a 400 token al secondo. Alla velocità di 200 token al secondo per conversazione che Abitbol indica, sono circa 110 conversazioni contemporanee in media, il 5-6% dei 2.000 ingegneri: plausibile, non verificabile (le ricette di vLLM e SGLang non pubblicano la velocità per scheda).
Ho letto la pagina del talk (https://ai.engineer/nyc/2026/talks/revolut) e la sua trascrizione il 5 novembre 2026; la trascrizione, dice la pagina, è automatica e può contenere errori. I minuti sono quelli della registrazione della diretta. I prezzi di GPU, API e abbonamenti sono i listini pubblicati sulle pagine dei fornitori e letti il 5 novembre 2026. I conti sono rifatti in R dai dati di ingresso, che conservo con fonte e ora di lettura.
Ipotesi dichiarate:
- mese di 730 ore; «in orario» = 10 ore per 22 giorni = 220 ore;
- prezzi pubblicati il 5 novembre 2026: on-demand (RunPod, Nebius, CoreWeave), cluster di Lambda, sconto massimo di CoreWeave; il listino delle istanze di Lambda, che entrerà in vigore il 16 novembre 2026 (fino ad allora si vede solo con un account), è fuori dai conti; il prezzo di Revolut non è noto;
- i 30 centesimi sono il costo diviso per tutti i token serviti, cache compresa; la fattura di oggi è il solo noleggio delle 56 GPU;
- «un decimo» letto anche tra l’8% e il 12%;
- prezzo medio delle API: 2-10% di token in uscita, cache al 50% o al 90% (scenari), scrittura in cache non contata (le API escono un po’ più economiche del vero: per Opus 5.5 da 3,6 a 8,7 volte invece di 3,2-8,4), listini di oggi;
- «uso come Revolut»: circa 580 milioni di token al mese per ingegnere (da 230 a 670 secondo il prezzo), token totali ricavati diviso 2.000, con 5% di token in uscita e cache al 90%;
- capacità di un server: il rapporto di Revolut (circa 36 sviluppatori per B200).
La soglia del 90% di cache è un consiglio di Abitbol sui parametri da regolare («check your cache hit, coding test needs to be above 90% cache hit», secondo la trascrizione automatica, poco chiara). Gli originali inglesi delle citazioni tradotte:
- «to serve 2,000 engineers, we roughly need 56 B200» (5:41:18);
- «blended cost of token is 30 cents per million» (5:42:17-5:42:19); «And so our invoice is one-tenth of what we were spending on Anthropic and OpenAI» (5:42:22-5:42:24);
- «request per second around 3» (5:43:08); «requests per second were over 7» (5:43:28); «88% improvement in performance for 76% increased demand» (5:43:35); «time to first token over 10 seconds» (5:43:15); «we’re around 1.6» (5:43:28); «We serve, in terms of interactivity, 200 tokens per second» (5:41:48-5:41:51);
- «engineers spend a thousand a month, 10,000 a month» (5:39:36-5:39:39); «we launched it with strict budget limits» (5:39:43);
- «So obviously we keep using codex, code code… But we keep them as exception» (5:40:59-5:41:07; «code code» è letto «Claude Code» perché a 5:47:04-5:47:07 la stessa trascrizione ha «And the sandbox means now if you’ve used Codex Claude Code, it has all of these features of approve for me»; la lettura non è confermata dall’audio);
- «you’re not using inference, dedicated endpoint that goes to China. you’re just getting the weights and putting them on a US-based service» (5:46:21-5:46:27).
Fonti
Consultate il 5 novembre 2026. Segno il tipo di ogni fonte: primaria (chi dice o produce il dato), listino (prezzi pubblici), progetto (documentazione di chi serve il modello).
- AI Engineer NYC 2026, «Shipping like a startup, regulated like a bank», David Abitbol (Revolut), 13 ottobre 2026: pagina del talk (riassunto senza autore indicato) e trascrizione automatica. Primaria per il parlato; il riassunto non ha un autore indicato. https://ai.engineer/nyc/2026/talks/revolut
- Diretta della conferenza su YouTube, dalle 5:36:54 alle 5:48:28 della registrazione. Primaria. https://www.youtube.com/watch?v=akEqiXFo3GM
- Prezzi di noleggio GPU: Lambda https://lambda.ai/pricing; RunPod https://www.runpod.io/pricing; Nebius https://nebius.com/prices; CoreWeave https://www.coreweave.com/pricing. Listino.
- Prezzi API e abbonamenti: Anthropic https://platform.claude.com/docs/en/about-claude/pricing e https://claude.com/pricing; OpenAI https://platform.openai.com/docs/pricing; Z.ai https://docs.z.ai/guides/overview/pricing e https://docs.z.ai/devpack/overview. Listino.
- Hugging Face,
zai-org/GLM-5.3(scheda, configurazione, licenza) ezai-org/GLM-5.3-Flash. Primaria. https://huggingface.co/zai-org/GLM-5.3 e https://huggingface.co/zai-org/GLM-5.3-Flash - vLLM recipes, GLM-5.3: https://recipes.vllm.ai/zai-org/GLM-5.3; SGLang cookbook, GLM-5.3: https://cookbook.sglang.io/autoregressive/GLM/GLM-5.3. Progetto.
- NIST CAISI, «CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities», 17 settembre 2026 (indica Z.ai come azienda con sede in Cina, già Zhipu AI, e il rilascio di GLM-5.3 il 14 agosto 2026). Primaria, indipendente. https://www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities
Leave a Reply